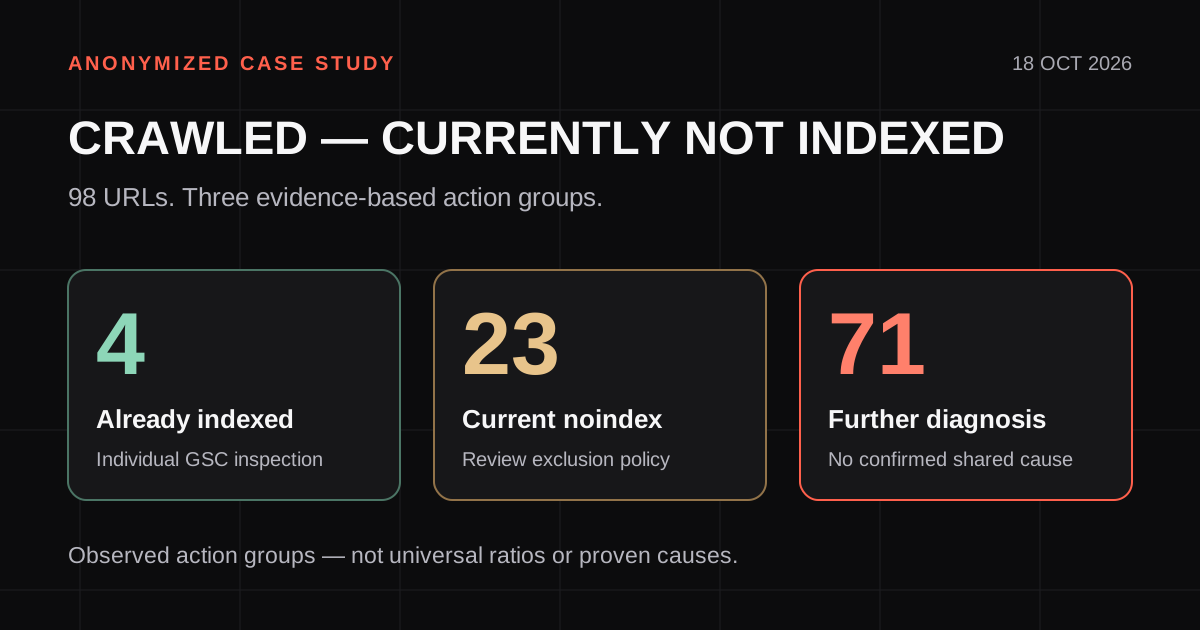
Из 98 URL в группе Crawled — currently not indexed только 71 остался кандидатом для дальнейшей диагностики после сверки данных. Четыре адреса индивидуальная проверка Google уже показывала как проиндексированные, а у 23 исходных адресов текущая конечная страница содержала noindex. Это результат нашего обследования, а не универсальная пропорция и не история успешного «возвращения 98 страниц в поиск».
Ниже — обезличенный разбор многоязычного образовательного сайта, проведённый 18 октября 2026 года. Домен и исходные адреса не публикуются; примеры обозначены стабильными номерами U001–U098. Мы не меняли страницы, не отправляли запросы индексирования и не запускали проверку исправлений. Собственный вклад исследования — сопоставление каждого адреса в сводном отчёте, URL Inspection и текущем HTTP-ответе.
Что именно вошло в исследование?
В группе «Просканировано — сейчас не проиндексировано» интерфейс показывал 98 адресов и строки 1–98 из 98. Мы зафиксировали весь доступный список, а затем открыли индивидуальную проверку каждого URL с раскрытым разделом индексирования. Исходная группа остаётся нашей выборкой: дальнейшее изменение статуса не исключает адрес из расчёта. Иначе сравнение потеряло бы именно те страницы, ради которых выполнялась сверка.
Заголовок отчёта был помечен обновлением от 12 октября, хотя некоторые строки уже содержали более поздние даты обхода. Мы сохранили оба наблюдения и не назначали всем данным единую дату актуальности. В пяти карточках индивидуальная проверка показала другую дату последнего сканирования, чем таблица примеров. Это подтверждает необходимость хранить дату конкретного поля, а не только дату выгрузки.
Google определяет этот статус как результат сканирования без включения страницы в индекс; сам по себе он не устанавливает конкретную причину. Для состояния отдельного адреса Google рекомендует URL Inspection, а список примеров отчёта может быть неполным. Поэтому наши выводы относятся к проверенным 98 строкам, не ко всем URL сайта. Описание отчёта и статуса в справке Google.
Как мы разделили три источника данных?
| Источник | Что фиксировали | Чего из этого не следует |
|---|---|---|
| Сводный отчёт | Исходную группу, адрес и дату в строке | Что старый статус описывает страницу прямо сейчас |
| URL Inspection: данные индекса | Статус, обход, доступность, директивы и canonical, если поля доступны | Что сохранённый HTML совпадает с текущей версией сайта |
| Публичный HTTP GET | Первый ответ, цепочку переходов, конечный HTML, robots и canonical | Что такую же версию получил Googlebot или что она уже проиндексирована |
HTTP-запросы выполнялись без авторизации и без представления роботом Google. Отдельно скачали текущий sitemap и проверили точное присутствие каждого исходного адреса. Из HTML собрали ссылки внутри обследуемой группы; весь сайт не обходили. Это позволяет подтвердить найденную ссылку, но не позволяет объявить страницу сиротой, если ссылка в ограниченной выборке не встретилась.
Мы не запускали в GSC проверку опубликованной страницы. Даже она отвечает на другой вопрос, чем сведения из индекса, и не подтверждает фактическую индексацию. Различие принципиально: собственный HTTP-запрос ещё уже по возможностям. Что проверяет URL Inspection.
Что подтвердилось для всех 98 адресов?
Все числа в следующих таблицах — результаты нашего обследования от 18 октября 2026 года. Сначала считаем исключительно статусы индивидуальной проверки, не смешивая их с директивами текущего сайта.
| Статус URL Inspection | URL | Вывод |
|---|---|---|
| Проиндексировано | 4 | Исключение в исходном списке уже не соответствует карточке URL |
| Crawled — currently not indexed | 93 | Статус сохраняется, конкретная причина ещё не установлена |
| Исключено тегом noindex | 1 | Google явно сообщает обнаруженную директиву |
| Всего | 98 | Каждый исходный адрес учтён один раз |
Во всех карточках сканирование было разрешено, а загрузка отмечена успешной. При этом в 27 карточках поле разрешения индексирования было недоступно. Мы не заменяли «недоступно» на «да»: отсутствие значения не является положительным результатом проверки.
Текущая HTTP-проверка дала другую группировку: 97 исходных адресов отвечали непосредственно кодом 200, один проходил цепочку 301 → 301 → 200. У конечных страниц 23 адресов найден noindex. Остальные 75 имели index, follow, canonical на себя и присутствовали в текущем sitemap. Наличие в sitemap — сигнал намерения владельца, а не подтверждение индексации. О возможностях sitemap.
Почему рабочая очередь сократилась до 71 URL?
Для распределения действий мы совместили результаты, не подменяя ими статусы Google. В этой выборке группы не пересекаются: 4 адреса уже в индексе, 23 имеют текущий запрет на конечной странице, 71 остаётся без подтверждённой индексации и без найденного текущего запрета. Расчёт: 98 − 4 − 23 = 71. Это количество кандидатов на дальнейший разбор, а не число доказанных технических ошибок.
| Группа действий | Количество | Следующий шаг |
|---|---|---|
| Уже в индексе | 4 | Проверять показы и полезность, не переписывать ради старой метки |
| Текущий noindex | 23 | Подтвердить редакционную политику исключения |
| Кандидаты на диагностику | 71 | Исследовать содержание, ссылки, дубли и отрисовку |
Из 23 исключённых текущими директивами страниц 21 — задания к урокам. В их HTML стоит canonical на основной урок, а в доступном шаблоне явно предусмотрен noindex. Ещё два случая — термин глоссария и конечная страница категории после редиректов. Эти адреса отсутствуют в текущем sitemap. Снимать запрет всей группе ради уменьшения числа в отчёте оснований нет; нужность каждой страницы в поиске должна быть отдельным решением.
Директива noindex — самостоятельное ограничение индексирования, а не способ исправить качество текста. Google должен получить страницу, чтобы прочитать такую директиву. Правила применения noindex.
Какие примеры показывают разницу между фактом и причиной?
| Пример | Подтверждено | Чего мы не утверждаем |
|---|---|---|
| U009: страница инструмента | В таблице обход 27 сентября; в URL Inspection — 16 октября и статус «проиндексировано» | Что её проиндексировало наше исследование или определённая правка |
| U011: задание | URL Inspection сообщает noindex; текущий HTML подтверждает его и canonical на урок | Что отсутствие задания в поиске является неисправностью |
| U012: другое задание | Сохранённые данные от 9 сентября разрешают индексирование; текущий HTML уже содержит noindex | Когда именно изменилась директива и почему ранее стоял Crawled |
| U079: урок | В сохранённых данных от 29 мая canonical не заявлен; сейчас в HTML он есть | Что отсутствие canonical было причиной исключения |
| U080: параметрический адрес | Сейчас два последовательных 301; конечная категория содержит noindex | Что сокращение цепочки само по себе вернёт исходный URL в индекс |
Для U080 можно рассмотреть прямой переход к конечному адресу вместо промежуточного. Это конкретная техническая рекомендация по наблюдаемой цепочке, но её нельзя выдавать за лечение прежнего статуса. Для U079 текущий canonical не требует повторного «добавления»: сначала следует сопоставить даты. И сам canonical не является приказом Google выбрать именно этот адрес. Как Google использует canonical.
Какие тревожные поля не доказали проблему?
В 50 карточках поле sitemap показывало временную ошибку обработки. Среди них оказались три из четырёх уже проиндексированных страниц. Поэтому наличие сообщения не позволяет в этом исследовании считать его достаточным объяснением исключения. Мы подтвердили сам текст сообщения, но не установили его причину, длительность или влияние. Текущий sitemap при нашей загрузке вернул 200 и разобрался как XML; это также не доказывает, что Google всегда получал тот же ответ.
У 16 адресов GSC не показал ссылающуюся страницу. Для девяти из этих адресов нашлись входящие ссылки из других страниц обследуемой группы. Это разные наблюдения, сделанные на разных слоях данных, а не доказательство ошибки Google. Практический вывод: пустое поле нельзя превращать в диагноз «страница-сирота». Для остальных адресов нужен полный обход сайта; отсутствие ссылки в частичной проверке недостаточно.
Такая дисциплина меняет постановку задачи. Вместо «исправить все ошибки sitemap и добавить ссылки всем сиротам» появляется проверяемое поручение: определить, какие файлы действительно недоступны, и построить актуальную карту внутренних ссылок. Только после этого можно выбирать изменение и оценивать его результат.
Какие причины остаются гипотезами?
| Гипотеза | Чего пока не хватает | Как проверить |
|---|---|---|
| Материал повторяет соседние страницы | Содержательного сравнения и оценки задач читателя | Сопоставить основные тексты, интенты и самостоятельную пользу страниц |
| Внутренних ссылок недостаточно | Полного графа ссылок и проверки значимых разделов | Просканировать сайт, проверить навигацию и контекст ссылок |
| Важный контент не виден после отрисовки | Проверки отрисованной версии и ресурсов | Изучить опубликованную страницу и доступную Google версию |
| После обновлений ещё нет нового обхода | Сопоставления истории выпусков с датами Google | Сохранить дату изменения и наблюдать следующий обход |
Мы не установили для 71 адреса общую причину исключения. Формулировки «тонкий контент», «санкции», «нехватка краулингового бюджета» или «Google не любит переводы» не следуют из собранных данных. Их нельзя включать в список подтверждённых проблем. Полезнее выбрать небольшую группу нужных читателю страниц, сформулировать для каждой проверку и сохранить результат до изменения.
Чего этот метод и инструмент не делают?
GSC URL Auditor для проверки выгрузки полезен как следующий шаг технической сверки; числа этого кейса получены отдельными проверками и не выдаются за результат работы инструмента. Ни загрузка HTML, ни таблица аудита не раскрывают внутреннее решение Google, не измеряют качество автоматически и не показывают полный граф ссылок без соответствующего обхода.
Исследование проведено на одном сайте и не является экспериментом с контрольной группой. Нет данных «до и после» исправлений, замеров прироста кликов или доказательства причинности. Повторный запрос сканирования тоже не обещает включения в результаты. Ограничения запроса повторного сканирования.
Что делать со своей выгрузкой дальше?
Сохраните исходную группу, присвойте адресам постоянные номера и разделите сведения отчёта, индивидуальной проверки и текущего сайта. Не меняйте состав выборки после обнаружения проиндексированного URL. Для каждого предполагаемого исправления запишите наблюдение, гипотезу, ожидаемый проверяемый результат и дату. Это позволит отличить реальное изменение от обновления отчётности.
Начать техническую сверку можно в аудиторе URL. Для терминологии используйте определение Crawled — currently not indexed, для последовательности работ — план диагностики индексирования. Главный результат такого разбора — обоснованная очередь действий, а не обещание обнулить все исключения.