Проблемы с индексацией: технический аудит от карты сайта до проверки URL
Технический аудит индексации проверяет, могут ли страницы, которые должны быть в Поиске, там быть, и почему нет, если их там нет. В руководстве: как превратить общий итог покрытия в очередь, как сопоставить статусы со следующей проверкой и какие ошибки выглядят как исправления.
✓ Сверено с документацией Google · 4 октября 2026
Что такое технический аудит индексации
Технический аудит индексации отвечает на один вопрос: могут ли страницы, которые должны быть в Поиске, там быть, а если нет — почему? Он начинается с отчёта «Индексирование страниц», который группирует известные Google URL по состояниям (отчёт об индексировании страниц). Статус — это очередь, а не первопричина: один и тот же ярлык может возникать по разным механизмам, а многие ярлыки описывают исключения, которые вы выбрали сами.
Google прямо пишет, что отсутствие в индексе часто нормально: правила robots.txt, теги noindex, дубликаты и удалённые страницы — обычные причины. Поэтому аудит гонится не за «всё проиндексировано», а за «каждая важная страница проиндексирована, а каждое исключение объяснено». Если урок как работает индексация вам не знаком, прочитайте его первым.
Четыре проверки для каждого URL
Не назначайте массовое исправление, пока URL не прошёл через эти вопросы.
- Назначение в Поиске. Должен ли этот канонический URL участвовать в Поиске, или это намеренный редирект, дубль, фильтр, приватная страница либо удаление?
- Управление доступом. Проверьте HTTP-ответ, доступность по robots.txt, noindex и то, может ли Google получить ресурсы, нужные для понимания страницы.
- Согласованность canonical. Сопоставьте редиректы, заявленный canonical, выбранный Google canonical, внутренние ссылки и наличие в карте сайта.
- Ценность страницы. Убедитесь, что отрисованная страница уникальна, полезна и достижима по внутренним ссылкам; одного ярлыка статуса недостаточно для диагноза качества.
Как превратить общий итог покрытия в очередь
Нейтральная карта сайта релиза с 240 URL. Разбор находит 38 намеренных исключений; из 202 важных URL проиндексированы 185, а 17 требуют проверки.
| Группа | URL | Решение |
|---|---|---|
| Отправленный список | 240 | исходный набор |
| Ожидаемые исключения | 38 | принять и задокументировать |
| Важный рабочий набор | 202 | 240 − 38 |
| Проиндексированные важные URL | 185 | наблюдать |
| Неожиданные исключения | 17 | проверить и назначить владельца |
Покрытие рабочего набора = 185 ÷ 202 × 100 = 91,6%
Очередь проверки = 202 − 185 = 17 URL
Процент — внутренний контроль, а не цель Google. Результат — очередь из 17 URL, разбитая по шаблонам и ценности для бизнеса, с доказательствами из проверки характерных URL.
Разбор в восемь шагов
Работайте с определённым набором URL и сохраняйте доказательства по каждому решению.
- Определите рабочий набор. Возьмите актуальные канонические URL из карты сайта, пакет релиза или важный для бизнеса каталог, а не весь обнаруженный список. Google просит абсолютные канонические URL, которые вы хотите видеть в результатах (создание карты сайта).
- Откройте причины в «Индексировании страниц». Запишите числа проиндексированных и непроиндексированных URL этого набора и выгрузите примеры, где возможно.
- Уберите ожидаемые исключения. Задокументируйте намеренные редиректы, дубли, страницы с noindex и удаления, чтобы они не попали в очередь правок.
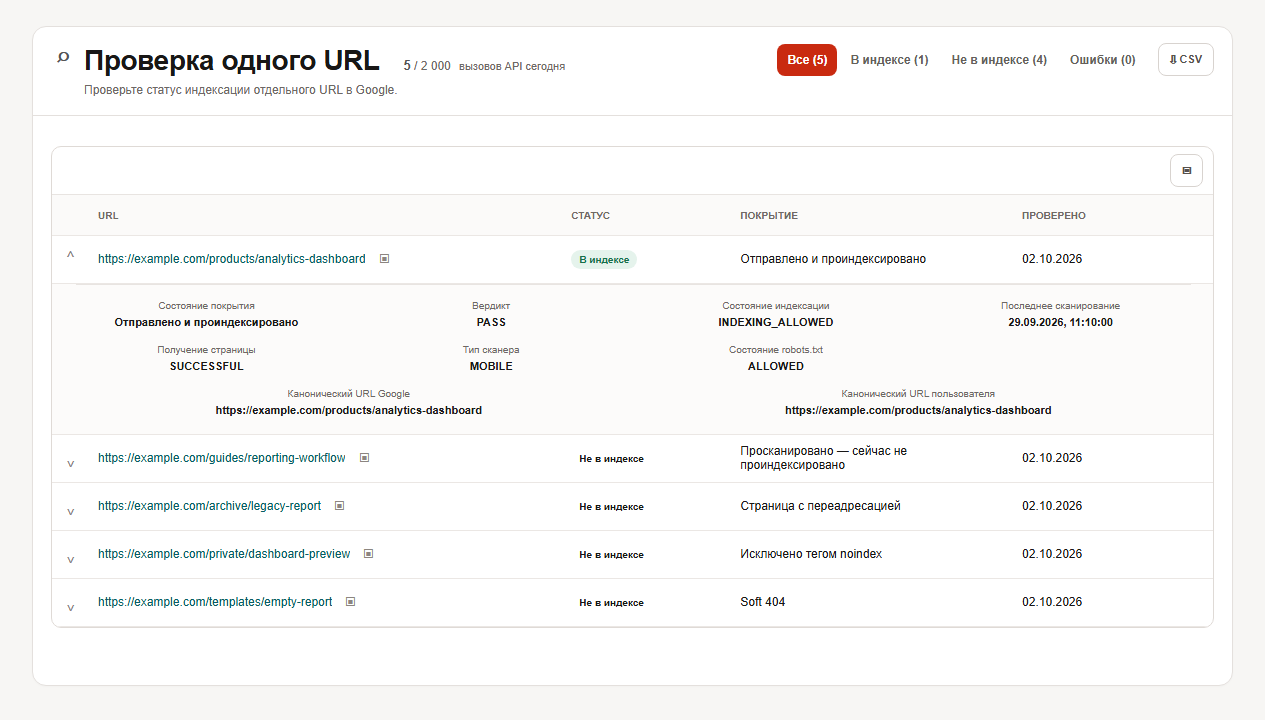
- Выберите примеры по шаблонам и ценности. Проверьте важные примеры из каждого неожиданного статуса, каталога и шаблона (инструмент проверки URL).
- Сравните индексированное и живое состояние. Запишите причину покрытия, последнее сканирование, состояние загрузки, состояние robots и заявленный и выбранный Google canonical.
- Подтвердите первопричину вне ярлыка: ответ сервера, отрисованный HTML, директивы, внутренние ссылки и карту сайта.
- Выкатите одно исправление по причине. Назначьте владельца и меняйте только то, что подтверждено доказательствами; проверьте один характерный URL, прежде чем применять к шаблону.
- Запросите повторное сканирование и наблюдайте. Для нескольких URL — «Запросить индексирование», для многих — карта сайта; ни то ни другое не гарантирует включения или сроков (запрос на повторное сканирование).
Сопоставьте доказательства со следующей проверкой
| Статус | Следующая проверка |
|---|---|
| Обнаружено — сейчас не проиндексировано Discovered – currently not indexed | Google нашёл URL, но ещё не сканировал его; обычно ожидал, что сканирование перегрузит сайт. Убедитесь, что URL должен быть в Поиске, затем проверьте пути обнаружения, внутренние ссылки, скорость сервера в отчёте «Статистика сканирования» и разрастание малоценных URL (отчёт «Статистика сканирования») |
| Просканировано — сейчас не проиндексировано Crawled – currently not indexed | Google просканировал страницу, но не проиндексировал, и пишет, что повторно отправлять её не нужно. Сравните живую отрисовку, canonical-сигналы, дублирование и полезность; единой причины Google не называет |
| Soft 404 Soft 404 | если контента нет, отдайте настоящий 404; если страница должна существовать, убедитесь, что она отдаёт осмысленное содержимое |
| Исключено тегом noindex Excluded by noindex | оставьте намеренные исключения; для важного URL уберите директиву и оставьте сканирование разрешённым, чтобы Google увидел изменение |
| URL заблокирован в robots.txt Blocked by robots.txt | исправьте случайный disallow там, где нужно сканирование; robots.txt — не способ убрать страницу из Google (введение в robots.txt) |
| Дубликат или другой canonical Duplicate / different canonical | проверьте оба canonical и согласуйте редиректы, rel=canonical, внутренние ссылки и сигналы карты сайта (объединение дубликатов URL) |
Ошибки, которые выглядят как исправления
- Закрыть страницу в robots.txt и добавить noindex. Чтобы noindex сработал, страница не должна быть заблокирована: если робот не может её открыть, он никогда не увидит правило, и страница всё равно может появиться в результатах (блокировка индексирования через noindex).
- Скрывать страницу через robots.txt. Он управляет нагрузкой от сканирования; чтобы убрать страницу из Google, используйте noindex или защиту паролем.
- Просить индексирование снова и снова. Есть квота, а повторные запросы по одному URL не ускоряют обход.
- Перечислять в карте сайта неканонические или относительные URL. Указывайте абсолютные канонические URL, которые хотите видеть в результатах.
- Считать живой тест индексированным состоянием. Он проверяет текущую доступную версию, которая может отличаться от индексированной и не гарантирует индексацию.
Чего этот разбор не докажет
- Цели в 100% нет. Google не ждёт, что проиндексирован каждый известный URL; здоровые исключения нормальны.
- Однозначных причин в ярлыках нет. Причина в отчёте суммирует состояние Google и не заменяет проверку сервера, отрисованной страницы и canonical.
- Фиксированного срока восстановления нет. Сканирование может занять от нескольких дней до нескольких недель и зависит от многих систем.
- Небольшому сайту это может не понадобиться. Google пишет, что при менее чем примерно 500 страницах отчёт об индексировании, скорее всего, не нужен; хватит проверок через
site:.
Очередь индексации
Для каждого неожиданного URL запишите: назначение, статус, HTTP-ответ, состояние robots и noindex, заявленный и выбранный Google canonical, последнее сканирование, ценность страницы, владельца и следующее действие. Проверьте одно характерное исправление, прежде чем применять к шаблону. Если результат неясен, запишите «недостаточно данных» и ничего не меняйте.
Проблемы с индексацией: частые вопросы
Почему мои страницы не индексируются?
Откройте «Проверку URL» и прочитайте причину: блокировка, noindex, дубликат, 404, soft 404, ошибка сервера или страницу просто ещё не сканировали. Затем спросите, должна ли страница вообще быть в Поиске.
Должна ли индексироваться каждая страница?
Нет. Исключения из-за robots.txt, noindex, дублирования или удаления — нормальны.
Можно ли использовать robots.txt и noindex вместе?
Нет: страница, закрытая в robots.txt, никогда не покажет роботу правило noindex.
Значит ли живой тест, что страница проиндексирована?
Нет. Он проверяет текущую доступную версию, а не индексированную.
Сколько раз можно запрашивать индексирование?
Есть квота, а повторные запросы по одному URL не ускоряют обход.
Что читать дальше
Вернитесь к улучшению CTR или неделе быстрых улучшений либо откройте проверку URL, чтобы начать собственный рабочий набор.