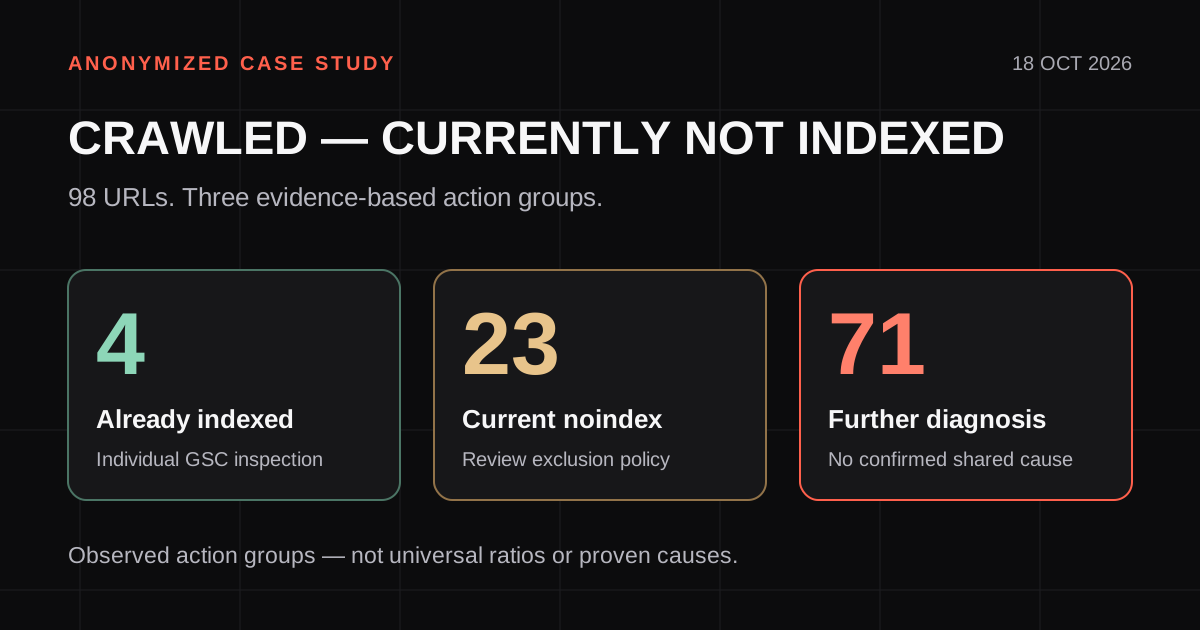
Із 98 URL у групі Crawled — currently not indexed лише 71 залишився кандидатом для подальшої діагностики після зіставлення даних. Чотири адреси індивідуальна перевірка Google вже показувала як проіндексовані, а для 23 початкових адрес поточна кінцева сторінка містила noindex. Це результат нашого обстеження, а не універсальна пропорція й не історія успішного «повернення 98 сторінок у пошук».
Нижче — знеособлений розбір багатомовного освітнього сайту, проведений 18 жовтня 2026 року. Домен і початкові адреси не публікуються; приклади мають сталі номери U001–U098. Ми не змінювали сторінки, не надсилали запити індексування й не запускали перевірку виправлень. Власний внесок дослідження — зіставлення кожної адреси у зведеному звіті, URL Inspection і поточній HTTP-відповіді.
Що саме увійшло до дослідження?
У групі «Проскановано — наразі не проіндексовано» інтерфейс показував 98 адрес і рядки 1–98 із 98. Ми зафіксували весь доступний список, а потім відкрили індивідуальну перевірку кожного URL з розгорнутим розділом індексування. Початкова група залишається нашою вибіркою: подальша зміна статусу не вилучає адресу з розрахунку. Інакше порівняння втратило б саме ті сторінки, заради яких виконувалося зіставлення.
Заголовок звіту мав позначку оновлення від 12 жовтня, хоча деякі рядки вже містили пізніші дати обходу. Ми зберегли обидва спостереження й не призначали всім даним єдину дату актуальності. У п’яти картках індивідуальна перевірка показала іншу дату останнього сканування, ніж таблиця прикладів. Тому важливо зберігати дату конкретного поля, а не тільки дату завантаження списку.
Google визначає цей статус як результат сканування без включення сторінки до індексу; сам він не встановлює конкретної причини. Для стану окремої адреси Google рекомендує URL Inspection, а список прикладів звіту може бути неповним. Наші висновки стосуються перевірених 98 рядків, а не всіх URL сайту. Опис звіту й статусу в довідці Google.
Як ми розділили три джерела даних?
| Джерело | Що фіксували | Чого це не доводить |
|---|---|---|
| Зведений звіт | Початкову групу, адресу й дату в рядку | Що старий статус описує сторінку саме зараз |
| URL Inspection: дані індексу | Статус, обхід, доступність, директиви та canonical, якщо поля доступні | Що збережений HTML збігається з поточною версією сайту |
| Публічний HTTP GET | Першу відповідь, ланцюжок переходів, кінцевий HTML, robots і canonical | Що таку саму версію отримав Googlebot або що вона вже проіндексована |
HTTP-запити виконувалися без авторизації та без представлення роботом Google. Окремо завантажили поточний sitemap і перевірили точну присутність кожної початкової адреси. З HTML зібрали посилання всередині досліджуваної групи; весь сайт не обходили. Це дозволяє підтвердити знайдене посилання, але не дозволяє оголосити сторінку сиротою, якщо посилання в обмеженій вибірці не трапилося.
Ми не запускали в GSC перевірку опублікованої сторінки. Навіть вона відповідає на інше запитання, ніж відомості з індексу, і не підтверджує фактичної індексації. Власний HTTP-запит ще вужчий за можливостями. Чітке розмежування не дозволяє представити успішне завантаження як успішне включення до пошуку. Можливості й обмеження URL Inspection.
Що підтвердилося для всіх 98 адрес?
Усі числа в наступних таблицях — результати нашого обстеження від 18 жовтня 2026 року. Спочатку рахуємо лише статуси індивідуальної перевірки, не змішуючи їх із директивами поточного сайту.
| Статус URL Inspection | URL | Висновок |
|---|---|---|
| Проіндексовано | 4 | Виключення в початковому списку вже не відповідає картці URL |
| Crawled — currently not indexed | 93 | Статус зберігається, конкретної причини ще не встановлено |
| Виключено тегом noindex | 1 | Google прямо повідомляє про виявлену директиву |
| Разом | 98 | Кожну початкову адресу враховано один раз |
У всіх картках сканування було дозволене, а завантаження позначене успішним. Водночас у 27 картках поле дозволу індексування було недоступним. Ми не замінювали «недоступно» на «так»: відсутність значення не є позитивним результатом перевірки.
Поточна HTTP-перевірка дала інший розподіл: 97 початкових адрес відповідали безпосередньо кодом 200, одна проходила ланцюжок 301 → 301 → 200. На кінцевих сторінках 23 адрес знайдено noindex. Решта 75 мали index, follow, canonical на себе й були присутні в поточному sitemap. Наявність у sitemap — сигнал наміру власника, а не підтвердження індексації. Про можливості sitemap.
Чому робоча черга скоротилася до 71 URL?
Для розподілу дій ми поєднали результати, не підміняючи ними статуси Google. У цій вибірці групи не перетинаються: 4 адреси вже в індексі, 23 мають поточну заборону на кінцевій сторінці, 71 залишається без підтвердженої індексації та без знайденої поточної заборони. Розрахунок: 98 − 4 − 23 = 71. Це кількість кандидатів на подальший розбір, а не число доведених технічних помилок.
| Група дій | Кількість | Наступний крок |
|---|---|---|
| Уже в індексі | 4 | Перевіряти покази й користь, не переписувати заради старої позначки |
| Поточний noindex | 23 | Підтвердити редакційну політику виключення |
| Кандидати на діагностику | 71 | Досліджувати вміст, посилання, дублікати й відтворення сторінки |
Із 23 сторінок, виключених поточними директивами, 21 — завдання до уроків. У їхньому HTML canonical указує на основний урок, а доступний шаблон прямо передбачає noindex. Ще два випадки — термін глосарія й кінцева сторінка категорії після перенаправлень. Ці адреси відсутні в поточному sitemap. Немає підстав знімати заборону для всієї групи заради зменшення числа у звіті; потрібність кожної сторінки в пошуку має бути окремим рішенням.
Директива noindex — самостійне обмеження індексування, а не спосіб виправити якість тексту. Google має отримати сторінку, щоб прочитати таку директиву. Це важливе розрізнення під час перевірки навмисно виключених допоміжних сторінок. Правила застосування noindex.
Які приклади показують різницю між фактом і причиною?
| Приклад | Підтверджено | Чого ми не стверджуємо |
|---|---|---|
| U009: сторінка інструмента | У таблиці обхід 27 вересня; у URL Inspection — 16 жовтня й статус «проіндексовано» | Що її проіндексувало наше дослідження або певна зміна |
| U011: завдання | URL Inspection повідомляє noindex; поточний HTML підтверджує його й canonical на урок | Що відсутність завдання в пошуку є несправністю |
| U012: інше завдання | Збережені дані від 9 вересня дозволяють індексування; поточний HTML уже містить noindex | Коли саме змінилася директива й чому раніше був статус Crawled |
| U079: урок | У збережених даних від 29 травня canonical не заявлений; зараз у HTML він є | Що відсутність canonical спричинила виключення |
| U080: параметрична адреса | Зараз два послідовні 301; кінцева категорія містить noindex | Що скорочення ланцюжка саме собою поверне початковий URL до індексу |
Для U080 можна розглянути прямий перехід до кінцевої адреси замість проміжного. Це конкретна технічна рекомендація щодо спостережуваного ланцюжка, але її не можна видавати за лікування давнього статусу. Для U079 поточний canonical не потребує повторного «додавання»: спочатку треба зіставити дати. І сам canonical не є наказом Google обрати саме цю адресу. Як Google використовує canonical.
Які тривожні поля не довели проблеми?
У 50 картках поле sitemap показувало тимчасову помилку обробки. Серед них виявилися три з чотирьох уже проіндексованих сторінок. Отже, саме повідомлення не дозволяє в цьому дослідженні вважати його достатнім поясненням виключення. Ми підтвердили текст повідомлення, але не встановили його причини, тривалості чи впливу. Поточний sitemap під час нашого завантаження повернув 200 і був прочитаний як XML; це також не доводить, що Google завжди отримував ту саму відповідь.
Для 16 адрес GSC не показав сторінки, що посилається. Для дев’яти з цих адрес знайшлися вхідні посилання з інших сторінок досліджуваної групи. Це різні спостереження, зроблені на різних шарах даних, а не доказ помилки Google. Практичний висновок: порожнє поле не можна перетворювати на діагноз «сторінка-сирота». Для решти адрес потрібен повний обхід сайту; відсутності посилання в частковій перевірці недостатньо.
Така дисципліна змінює постановку завдання. Замість «виправити всі помилки sitemap і додати посилання всім сиротам» з’являється перевірюване доручення: визначити, які файли справді недоступні, та побудувати актуальну карту внутрішніх посилань. Лише після цього можна обирати зміну й оцінювати її результат.
Які причини залишаються гіпотезами?
| Гіпотеза | Чого поки бракує | Як перевірити |
|---|---|---|
| Матеріал повторює сусідні сторінки | Змістового порівняння й оцінки завдань читача | Зіставити основні тексти, наміри й самостійну користь сторінок |
| Внутрішніх посилань недостатньо | Повного графа посилань і перевірки важливих розділів | Просканувати сайт, перевірити навігацію та контекст посилань |
| Важливий вміст не видно після відтворення | Перевірки відтвореної версії та ресурсів | Дослідити опубліковану сторінку й доступну Google версію |
| Після оновлень ще немає нового обходу | Зіставлення історії випусків із датами Google | Зберегти дату зміни та спостерігати наступний обхід |
Ми не встановили для 71 адреси спільної причини виключення. Формулювання «тонкий контент», «санкції», «нестача бюджету сканування» чи «Google не любить переклади» не випливають із зібраних даних. Їх не можна додавати до переліку підтверджених проблем. Корисніше обрати невелику групу потрібних читачеві сторінок, сформулювати перевірку для кожної та зберегти початковий результат до зміни.
Чого цей метод та інструмент не роблять?
GSC URL Auditor для перевірки експорту корисний як наступний крок технічного зіставлення; числа цього кейсу отримані окремими перевірками й не видаються за результат роботи інструмента. Ані завантаження HTML, ані таблиця аудиту не розкривають внутрішнього рішення Google, не вимірюють якість автоматично й не показують повного графа посилань без відповідного обходу.
Дослідження проведене на одному сайті й не є експериментом із контрольною групою. Немає даних «до та після» виправлень, вимірювань приросту кліків або доказу причинності. Повторний запит сканування також не обіцяє включення до результатів. Обмеження запиту повторного сканування.
Що робити зі своїм експортом далі?
Збережіть початкову групу, надайте адресам сталі номери й розділіть відомості звіту, індивідуальної перевірки та поточного сайту. Не змінюйте складу вибірки після виявлення проіндексованого URL. Для кожного запропонованого виправлення запишіть спостереження, гіпотезу, очікуваний перевірюваний результат і дату. Це дозволить відрізнити реальну зміну від оновлення звітності.
Почати технічне зіставлення можна в аудиторі URL. Для термінології використовуйте визначення Crawled — currently not indexed, для послідовності робіт — план діагностики індексування. Головний результат такого розбору — обґрунтована черга дій, а не обіцянка обнулити всі виключення.