Проблеми з індексацією: технічний аудит від мапи сайту до перевірки URL
Технічний аудит індексації перевіряє, чи можуть сторінки, які мають бути в Пошуку, там бути, і чому ні, якщо їх там немає. У посібнику: як перетворити загальний підсумок покриття на чергу, як зіставити статуси з наступною перевіркою та які помилки виглядають як виправлення.
✓ Звірено з документацією Google · 4 жовтня 2026
Що таке технічний аудит індексації
Технічний аудит індексації відповідає на одне питання: чи можуть сторінки, які мають бути в Пошуку, там бути, а якщо ні — чому? Він починається зі звіту «Індексування сторінок», який групує відомі Google URL за станами (звіт про індексування сторінок). Статус — це черга, а не першопричина: один і той самий ярлик може виникати за різними механізмами, а багато ярликів описують винятки, які ви обрали самі.
Google прямо пише, що відсутність в індексі часто нормальна: правила robots.txt, теги noindex, дублікати та видалені сторінки — звичайні причини. Тому аудит ганяється не за «усе проіндексовано», а за «кожна важлива сторінка проіндексована, а кожне виключення пояснене». Якщо урок як працює індексація вам не знайомий, прочитайте його першим.
Чотири перевірки для кожного URL
Не призначайте масове виправлення, поки URL не пройшов через ці питання.
- Призначення в Пошуку. Чи має цей канонічний URL брати участь у Пошуку, чи це навмисний редірект, дублікат, фільтр, приватна сторінка або видалення?
- Керування доступом. Перевірте HTTP-відповідь, доступність за robots.txt, noindex і те, чи може Google отримати ресурси, потрібні для розуміння сторінки.
- Узгодженість canonical. Зіставте редіректи, заявлений canonical, вибраний Google canonical, внутрішні посилання та наявність у мапі сайту.
- Цінність сторінки. Переконайтеся, що відрендерена сторінка унікальна, корисна й досяжна за внутрішніми посиланнями; самого ярлика статусу недостатньо для діагнозу якості.
Як перетворити загальний підсумок покриття на чергу
Нейтральна мапа сайту релізу з 240 URL. Розбір знаходить 38 навмисних виключень; із 202 важливих URL проіндексовано 185, а 17 потребують перевірки.
| Група | URL | Рішення |
|---|---|---|
| Надісланий перелік | 240 | початковий набір |
| Очікувані виключення | 38 | прийняти й задокументувати |
| Важливий робочий набір | 202 | 240 − 38 |
| Проіндексовані важливі URL | 185 | спостерігати |
| Неочікувані виключення | 17 | перевірити й призначити власника |
Покриття робочого набору = 185 ÷ 202 × 100 = 91,6%
Черга перевірки = 202 − 185 = 17 URL
Відсоток — внутрішній контроль, а не ціль Google. Результат — черга з 17 URL, розбита за шаблонами й цінністю для бізнесу, з доказами з перевірки характерних URL.
Розбір у вісім кроків
Працюйте з визначеним набором URL і зберігайте докази щодо кожного рішення.
- Визначте робочий набір. Візьміть актуальні канонічні URL із мапи сайту, пакет релізу чи важливий для бізнесу каталог, а не весь виявлений перелік. Google просить абсолютні канонічні URL, які ви хочете бачити в результатах (створення мапи сайту).
- Відкрийте причини в «Індексуванні сторінок». Запишіть кількість проіндексованих і непроіндексованих URL цього набору й вивантажте приклади, де можливо.
- Приберіть очікувані виключення. Задокументуйте навмисні редіректи, дублікати, сторінки з noindex і видалення, щоб вони не потрапили в чергу правок.
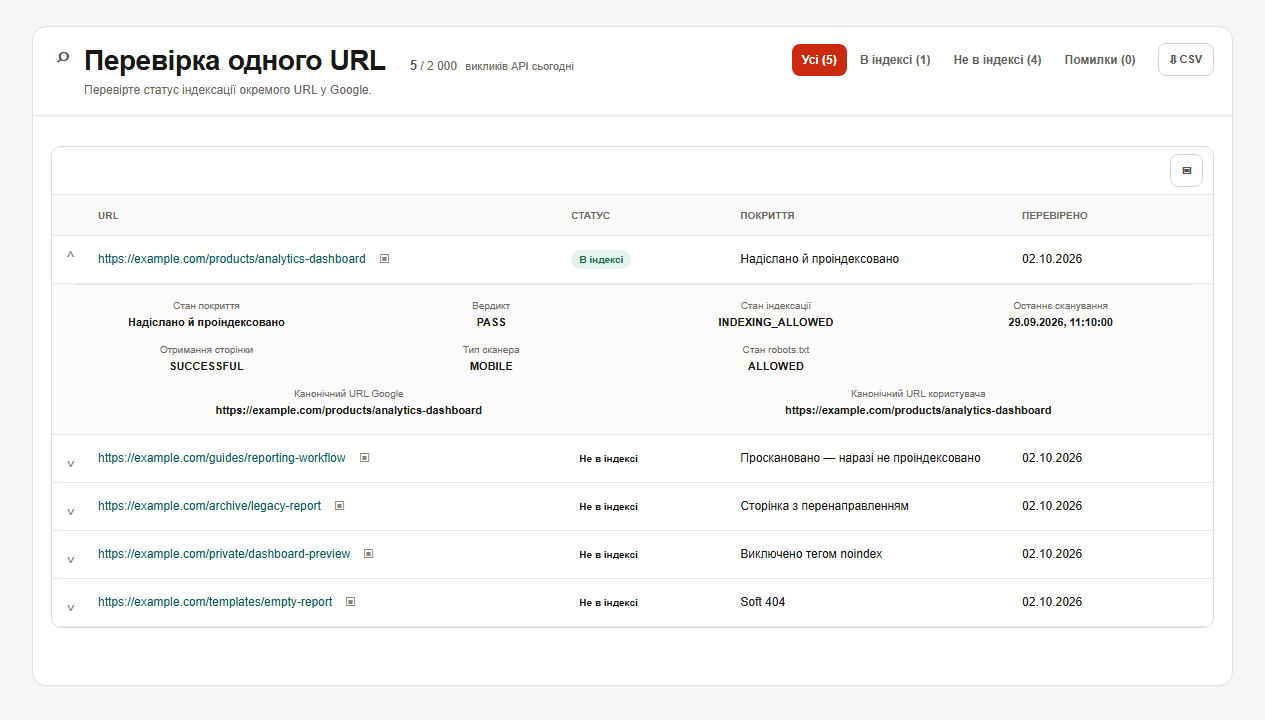
- Виберіть приклади за шаблонами й цінністю. Перевірте важливі приклади з кожного неочікуваного статусу, каталогу та шаблону (інструмент перевірки URL).
- Порівняйте індексований і живий стан. Запишіть причину покриття, останнє сканування, стан завантаження, стан robots і заявлений та вибраний Google canonical.
- Підтвердьте першопричину поза ярликом: відповідь сервера, відрендерений HTML, директиви, внутрішні посилання й мапу сайту.
- Викотіть одне виправлення за причиною. Призначте власника й змінюйте лише те, що підтверджено доказами; перевірте один характерний URL, перш ніж застосовувати до шаблону.
- Запросіть повторне сканування й спостерігайте. Для кількох URL — «Запросити індексування», для багатьох — мапа сайту; ні те, ні інше не гарантує включення чи строків (запит на повторне сканування).
Зіставте докази з наступною перевіркою
| Статус | Наступна перевірка |
|---|---|
| Виявлено — наразі не проіндексовано Discovered – currently not indexed | Google знайшов URL, але ще не сканував його; зазвичай очікував, що сканування перевантажить сайт. Переконайтеся, що URL має бути в Пошуку, потім перевірте шляхи виявлення, внутрішні посилання, швидкість сервера у звіті «Статистика сканування» та розростання малоцінних URL (звіт «Статистика сканування») |
| Проскановано — наразі не проіндексовано Crawled – currently not indexed | Google просканував сторінку, але не проіндексував, і пише, що повторно надсилати її не потрібно. Порівняйте живе відтворення, canonical-сигнали, дублювання та корисність; єдиної причини Google не називає |
| Soft 404 Soft 404 | якщо вмісту немає, віддайте справжній 404; якщо сторінка має існувати, переконайтеся, що вона віддає змістовний вміст |
| Виключено тегом noindex Excluded by noindex | залиште навмисні виключення; для важливого URL приберіть директиву й залиште сканування дозволеним, щоб Google побачив зміну |
| URL заблоковано в robots.txt Blocked by robots.txt | виправте випадковий disallow там, де потрібне сканування; robots.txt — не спосіб прибрати сторінку з Google (вступ до robots.txt) |
| Дублікат або інший canonical Duplicate / different canonical | перевірте обидва canonical і узгодьте редіректи, rel=canonical, внутрішні посилання й сигнали мапи сайту (обʼєднання дублікатів URL) |
Помилки, що виглядають як виправлення
- Закрити сторінку в robots.txt і додати noindex. Щоб noindex спрацював, сторінка не має бути заблокована: якщо робот не може її відкрити, він ніколи не побачить правило, і сторінка все одно може зʼявитися в результатах (блокування індексування через noindex).
- Приховувати сторінку через robots.txt. Він керує навантаженням від сканування; щоб прибрати сторінку з Google, використайте noindex або захист паролем.
- Просити індексування знову і знову. Є квота, а повторні запити щодо одного URL не пришвидшують обхід.
- Перелічувати в мапі сайту неканонічні чи відносні URL. Вказуйте абсолютні канонічні URL, які хочете бачити в результатах.
- Вважати живий тест індексованим станом. Він перевіряє поточну доступну версію, яка може відрізнятися від індексованої й не гарантує індексацію.
Чого цей розбір не доведе
- Цілі у 100% немає. Google не очікує, що проіндексовано кожен відомий URL; здорові виключення нормальні.
- Однозначних причин у ярликах немає. Причина у звіті підсумовує стан Google і не замінює перевірку сервера, відрендереної сторінки та canonical.
- Фіксованого строку відновлення немає. Сканування може тривати від кількох днів до кількох тижнів і залежить від багатьох систем.
- Невеликому сайту це може не знадобитися. Google пише, що за менш ніж приблизно 500 сторінок звіт про індексування, найімовірніше, не потрібен; вистачить перевірок через
site:.
Черга індексації
Для кожного неочікуваного URL запишіть: призначення, статус, HTTP-відповідь, стан robots і noindex, заявлений та вибраний Google canonical, останнє сканування, цінність сторінки, власника й наступну дію. Перевірте одне характерне виправлення, перш ніж застосовувати до шаблону. Якщо результат неясний, запишіть «недостатньо даних» і нічого не змінюйте.
Проблеми з індексацією: часті питання
Чому мої сторінки не індексуються?
Відкрийте «Перевірку URL» і прочитайте причину: блокування, noindex, дублікат, 404, soft 404, помилка сервера або сторінку просто ще не сканували. Потім запитайте, чи має сторінка взагалі бути в Пошуку.
Чи має індексуватися кожна сторінка?
Ні. Виключення через robots.txt, noindex, дублювання чи видалення — нормальні.
Чи можна використовувати robots.txt і noindex разом?
Ні: сторінка, закрита в robots.txt, ніколи не покаже роботу правило noindex.
Чи означає живий тест, що сторінка проіндексована?
Ні. Він перевіряє поточну доступну версію, а не індексовану.
Скільки разів можна запитувати індексування?
Є квота, а повторні запити щодо одного URL не пришвидшують обхід.
Що читати далі
Поверніться до покращення CTR або тижня швидких покращень чи відкрийте перевірку URL, щоб почати власний робочий набір.